
ChatGPT / GPT 版本怎么选:普通人决策清单(2026)
面对 ChatGPT 与 GPT 多版本时如何选择:按任务难度、速度与成本决策,附盲测方法和切换时机。区别于套餐对比与三模型横评,专注「版本能力」怎么用。
- 作者
- ChatGPT博客编辑部
- 发布时间
- 阅读时长
- 约 4 分钟阅读
每次 GPT / ChatGPT 更新,都会刷到「最新最强」的说法。普通人真正卡住的是:默认选哪个版本?什么时候值得换更强的?
本文给你一份可执行的决策清单。它和 免费版 vs Plus(讲钱与权益)、ChatGPT vs Claude vs Gemini(讲跨厂选型)不同——这里只谈 同一产品线里,版本能力怎么选。
界面上的具体型号名会随时间变化,方法不变:按任务选,不按热搜选。想边测边用,可打开 ChatGPT 使用入口。
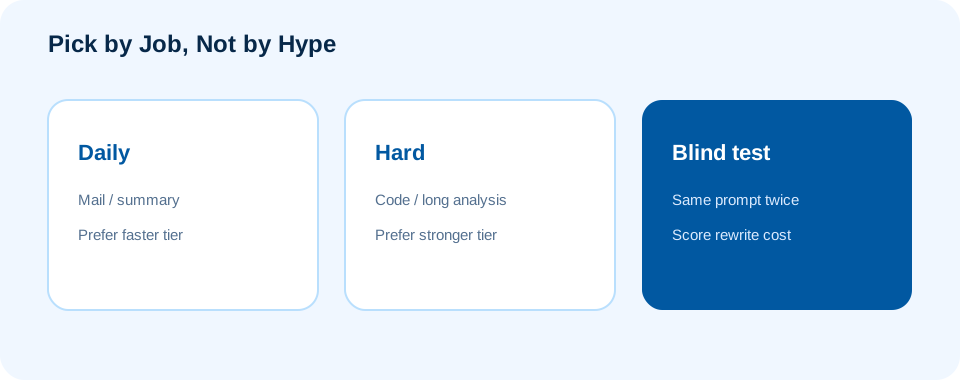
先记住三条原则
- 最新 ≠ 每次都更好:有的更新偏速度,有的偏推理;要以你的任务结果为准。
- 可逆草稿用更快档:邮件、摘要、头脑风暴,优先吞吐。
- 高风险输出用更强档 + 人工核对:对外方案、关键代码、合规相关内容。
具体开放哪些模型、是否收费,以你账号内展示为准;本站为第三方教程,与 OpenAI 无关联。
五分钟决策树
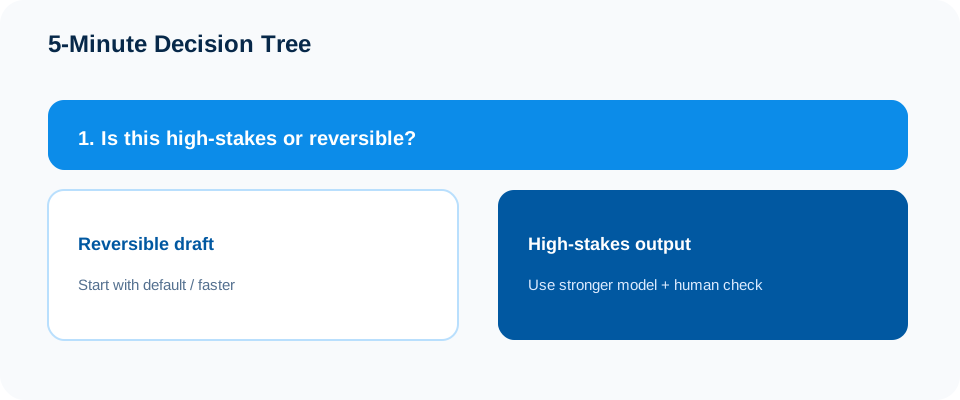
问自己四个问题:
| 问题 | 若「是」 | 更倾向 |
|---|---|---|
| 出错代价高吗?(法务/资金/安全) | 是 | 更强模型 + 人工审 |
| 需要多步推理或长文结构吗? | 是 | 更强模型 |
| 只要短平快可用草稿吗? | 是 | 默认/更快档 |
| 要大量重复生成(多标题、多文案)? | 是 | 更快档,再挑优 |
用「盲测」代替跟风
版本争议永远吵不完。用你自己的 3 个真实任务做对比:
对每个任务:
请完成下列任务。不要解释模型身份。
评分标准:我只需可用结果。
任务:
{固定同一段提示词}记录:一次成功率、你手工改了几处、总耗时。两周后大版本更新,用同一套题再测一次。
推荐的默认策略(可写进 Projects)
结合 Projects 与自定义指令,可以这样固化:
默认策略:
- 邮件/周报/翻译润色:使用更快、响应更稳的选项
- 复杂代码、长文档分析、重要对外稿:切换更强选项
- 任何涉及数字、法务、医疗建议:必须人工核实
把这段放进对应 Project 说明,避免每次纠结。
和套餐选择怎么配合
- 会不会用:先保证能进入对话并完成任务(见 ChatGPT 介绍)
- 要不要付费:看使用频率与限额,见 免费版 vs Plus
- 用哪一档模型:用本文决策树 + 盲测
付费解决的是额度与功能面;版本选择解决的是单次任务质量与速度的权衡。两者别混为一谈。
思考模型 / 更慢更稳的选项怎么放进决策树
产品里若出现「思考更深 / 推理更强 / 更慢更贵」一类选项(名称以账号内实际为准),用下面规则,而不是追版本号新闻:
- 默认快档:邮件、翻译润色、短大纲、简单改写
- 升到强档:多约束长文、复杂代码、需要分步核对的分析
- 只有在强档仍翻车时再开「更重推理」:题干含多步逻辑、易自相矛盾的规划题
- 永远人工终审:涉及金额、法律、医疗、对外承诺
图像相关任务不要挤进「文本模型排行」:配图流程见 图像生成提示词,产品线更新见 Images 上手。
我们明确不做的事(反版本工厂)
不会为每一个新模型号单独开「GPT-x.y 国内使用」文章。新名称出现时:
上次核对
- 页面策略核对:2026-09-18
- 具体模型名单与定价:以你账号内选项与官方定价页为准,本文不硬编码易过期价目
常见误区
| 误区 | 更好做法 |
|---|---|
| 永远开最强 | 日常草稿浪费时间与额度 |
| 只看发布会形容词 | 固定题库复测 |
| 换版本却不改提示词 | 先优化提示词,再比模型 |
| 拿测评博主结论当真理 | 用你的岗位真实任务验证 |
| 每个版本号搜一篇「国内教程」 | 回本文 + 国内指南,拒绝门页 |
使用入口
相关阅读
相关阅读
评论
评论功能即将上线,欢迎先通过关于页联系我们反馈意见。